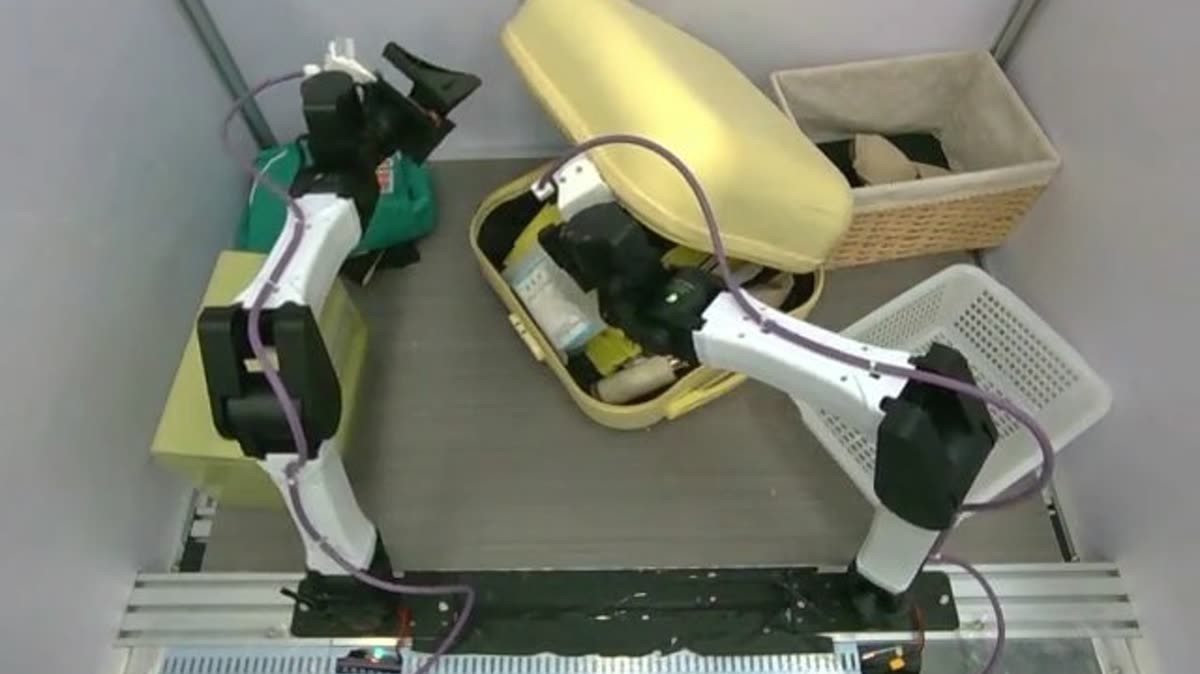
Өмнөд Солонгосын KAIST их сургууль болон NVIDIA компанийн судлаачид хамтран урьдчилан сургасан видео тархалтын загварыг бүх төрлийн биетэд нийцэх хөдөлгөөн суралцагч болгон хувиргадаг DreamX системийг (cvlab-kaist.github.io/DreamX) танилцууллаа.
Хүн ба роботод зориулсан нэгдмэл үйлдлийн орон зай
Робот сургалтын гол бэрхшээл нь хүний гар болон янз бүрийн бүтэцтэй роботуудын хөдөлгөөнийг нэг хэлбэрт оруулах явдал байдаг. DreamX энэ асуудлыг шийдэхдээ Cosmos Predict 2.5 видео загварыг кодлогч болон тайлагчийн үүргээр зэрэг ажиллуулж, дүрсний гадаад төрхийг хөдөлгөөнөөс нь бүрэн салгажээ.
Систем нь гурван үндсэн үе шаттайгаар ажиллана:
- Хөдөлгөөнийг ялган унших: Суралцах чадвартай асуулгын векторууд (learnable queries) нь видеоны онцлогоос кадр бүрд ердөө 4 токен буюу ердийн видеоны далд дүрслэлээс 300 дахин бага хэмжээтэй «далд үйлдэл» (latent action) ялгаж авна.
- Ирээдүйн кадрыг сэргээх: Тайлагч (decoder) нь зөвхөн эхний кадр болон шахагдсан далд үйлдлийн кодыг хэрэглэн дараагийн кадруудыг үүсгэдэг тул уг код нь өнгө үзэмж бус цэвэр хөдөлгөөний мэдээллийг агуулдаг.
- Төрөл бүрийн роботод шилжүүлэх: Нэгэнт ялгаж авсан хөдөлгөөний кодыг өөр орчны видео үүсгэх, хүний бичлэгээс роботын үйлдэл рүү хөрвүүлэх (Bridge WidowX, Bimanual YAM, AgiBot зэрэг робот хооронд) болон роботын удирдлагын бодлого сургахад шууд хэрэглэнэ.
2,190 цагийн бичлэг ба сорилын үр дүн
Судалгааны баг 6 өөр өгөгдлийн сангаас бүрдсэн нийт 2,190 цагийн хүний (нэгдүгээр биеийн камертай) болон роботын бичлэг дээр загвараа сургасан бөгөөд хүний бичлэгт ямар нэгэн үйлдлийн хаяг шошго шаардаагүй байна.
- LARYBench сорил: Роботын гарны траекторыг таамаглах болон хөдөлгөөн ангилах сорилд дундаж квадрат алдааг (MSE) 0.17 болгон бууруулсан нь өмнөх шилдэг загварын үзүүлэлтээс (0.38) хоёр дахин илүү нарийвчлалтай гарчээ.
- Хүнээс робот руу шууд шилжүүлэх (Zero-shot transfer): Хүний үйлдлийг роботын хөдөлгөөн болгон хувиргах чанарын FVD үзүүлэлт дээр 57.4 оноо авсан нь өмнөх суурь загваруудын 170.2 оноог хол орхисон үр дүн болов.