OpenAI компани 2026 оны 11 дүгээр сарын 17-нд шинэ үеийн GPT-6.2 Astra болон GPT-6.2 Sol загваруудаа албан ёсоор танилцууллаа. Нэг талаас байгууллагын баримт бичиг, 3D загварчлал, шинжлэх ухааны тооцооллын чадамж ахиж үнэ хямдарсан боловч нөгөө талаас бие даасан туршилт болон анхны хэрэглэгчдийн санал хүсэлтээс харахад эдгээр загвар олон нийтийн таамагласнаас тэс өөр онцлог, хязгаартай гарч ирлээ.
Загваруудын байр суурь ба үнийн бууралт
OpenAI шинэ загвараа бүх төрөлд «ухаалаг үсрэлт» хийсэн гэж сурталчлахаас илүүтэй илүү цөөн токен зарцуулж ижил буюу өндөр үр дүн гаргах бүтээмжид төвлөрчээ:
- GPT-6.2 Astra: Хамгийн ээдрээтэй шинжлэх ухаан, 3D/CAD, санхүү, хууль болон урт хугацааны агент даалгаварт зориулсан тэргүүлэгч загвар. API үнэ 1 сая оролтын токен тутамд $8.00 (өмнөх GPT-6 Astra-аас 20% хямд), кэшилсэн оролт $0.40 (60% хямдрал), гаралт $40.00 болж буурчээ.
- GPT-6.2 Sol: Өдөр тутмын техникийн болон оффисын ажлын үндсэн хурдан загвар. OpenAI-ийн ажилтнуудын дийлэнх нь дотооддоо анхдагчаар хэрэглэж буй бөгөөд API үнэ нь GPT-6.1 Sol-той адил $2.00 / $0.10 (кэш) / $10.00 хэвээр байна.
- Хүртээмж: ChatGPT Plus, Pro, Enterprise, Edu, ChatGPT Work, Codex болон API (
gpt-6.2-astra,gpt-6.2-sol) дээр нээгдсэн. Ultrafast горим Pro 500 хэрэглэгчдэд хоёр загварт, харин Pro 200-д анх удаа GPT-6.2 Sol дээр идэвхэжжээ.
Бенчмарк ба «бага токены» нууц
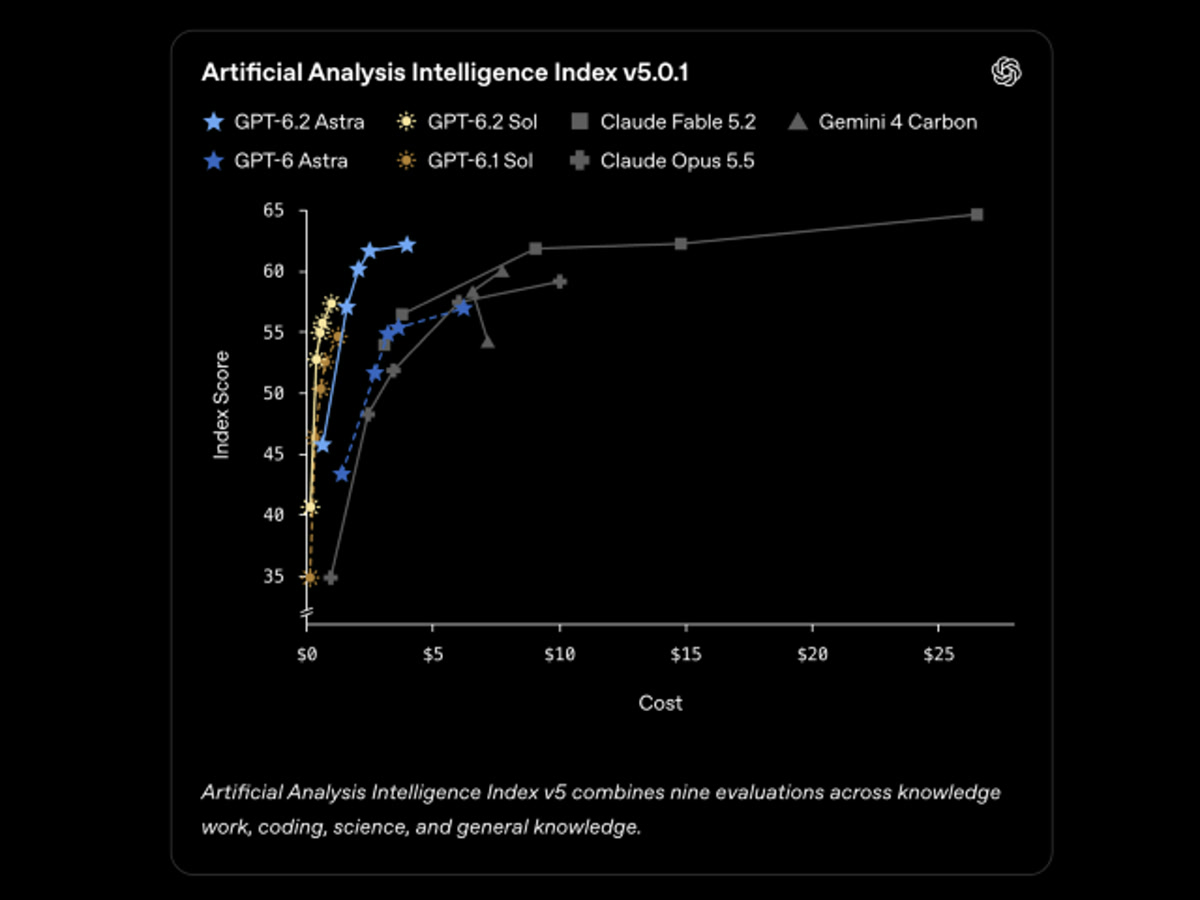
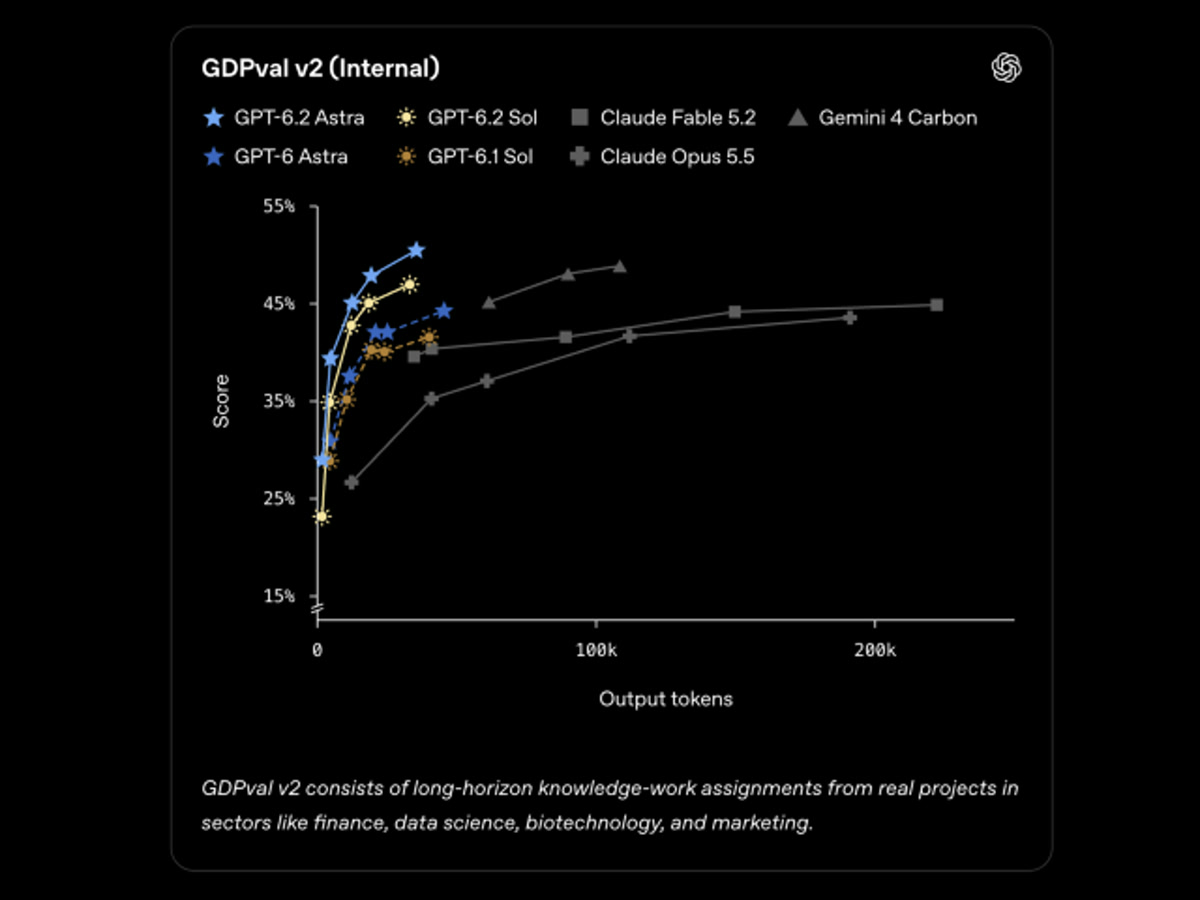
Гүйцэтгэлийн хараат бус болон дотоод сорилтуудад GPT-6.2 Astra зардлын үр ашгаар онцгойрч байна:
- Artificial Analysis Intelligence Index v5.0.1: Claude Fable 5.2 65 оноогоор 1 дүгээр байраа хадгалсан бол GPT-6.2 Astra 5 оноо ахиж 62 оноогоор 2 дугаарт (Gemini 4 Carbon ба Claude Opus 5.5-ын өмнө) орлоо. Хамгийн анхаарал татах зүйл нь хоёр загвар ижил $8/$40 API үнэтэй ч Astra бага гаралтын токен үүсгэдэг тул нийт тестийг ~4 доллароор (Fable 5.2 нь ~26 доллар) гүйцэтгэжээ.
- Agents' Last Exam v1.1 ба Шинжлэх ухаан: Урт хугацааны агент даалгаварт GPT-6.2 Astra ~78.3% хүрч GPT-6 Astra-аас +5.2 нэгж (гурав дахин хямд зардлаар), Claude Fable 5.2-оос +5.5 нэгж (5% зардлаар) илүү гарлаа. Terminal-Bench-Science 0.1 дээр өмнөх Astra-аас +9 хувийн нэгж дээшилж ~77%, Vals Science Index-т шинэ дээд ~68.5%, AA-3D үнэлгээнд 1,318 Elo (#1) авчээ.
- Мэргэжлийн баримт ба эрх зүй: Harvey-LAB-AA v1.1 хууль эрх зүйн шалгалтад Fable 5.2-ын амжилтыг 2 дахин давж (~15% орчим, ~1/6 зардал), AA-AnalystAgent санхүүгийн шинжилгээнд 5 оролдлогын бүгдэд нь 62.5% зөв хариулсан байна.
3D загварчлал, CAD ба инженерчлэлийн үзүүлбэр
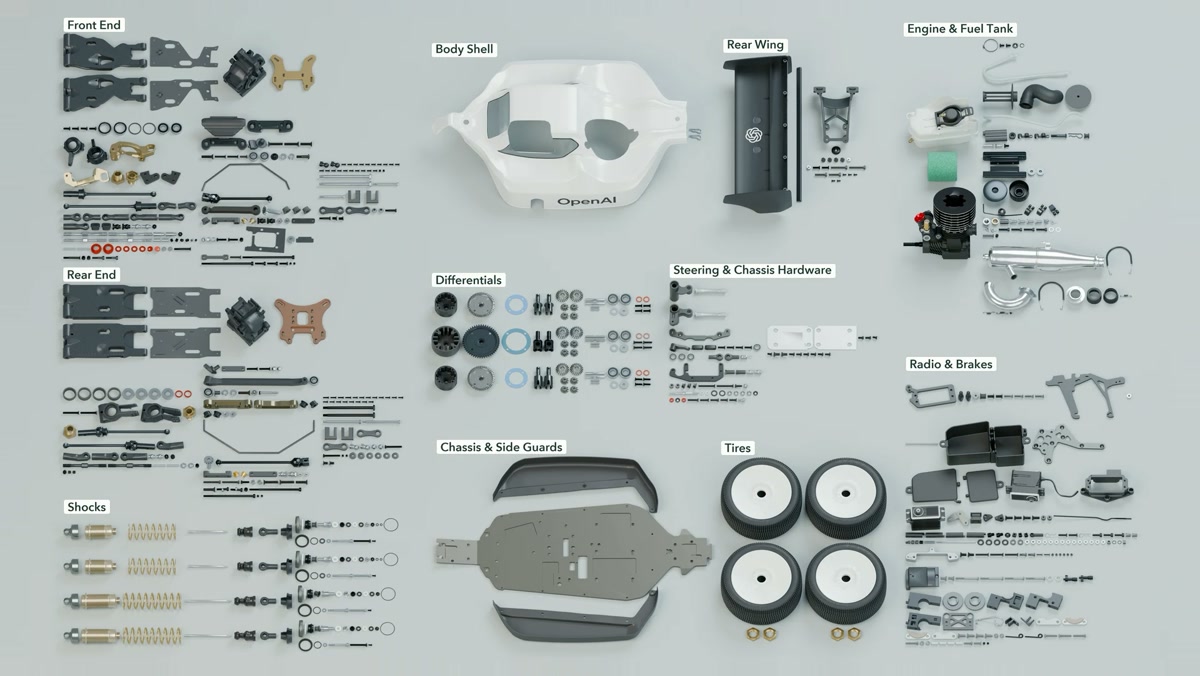
OpenAI албан ёсны нийтлэлдээ бодит инженерийн зураг, фото ба угсралтын гарын авлагаас нарийн 3D эд анги босгох чадварыг голчлон үзүүлэв. Тэдгээрийн дотор алсын удирдлагатай машины (RC buggy) болон зургаан цилиндртэй хөдөлгүүрийн эд анги бүрийг салгасан каталог, угсралтын хөдөлгөөнт заавар багтжээ.
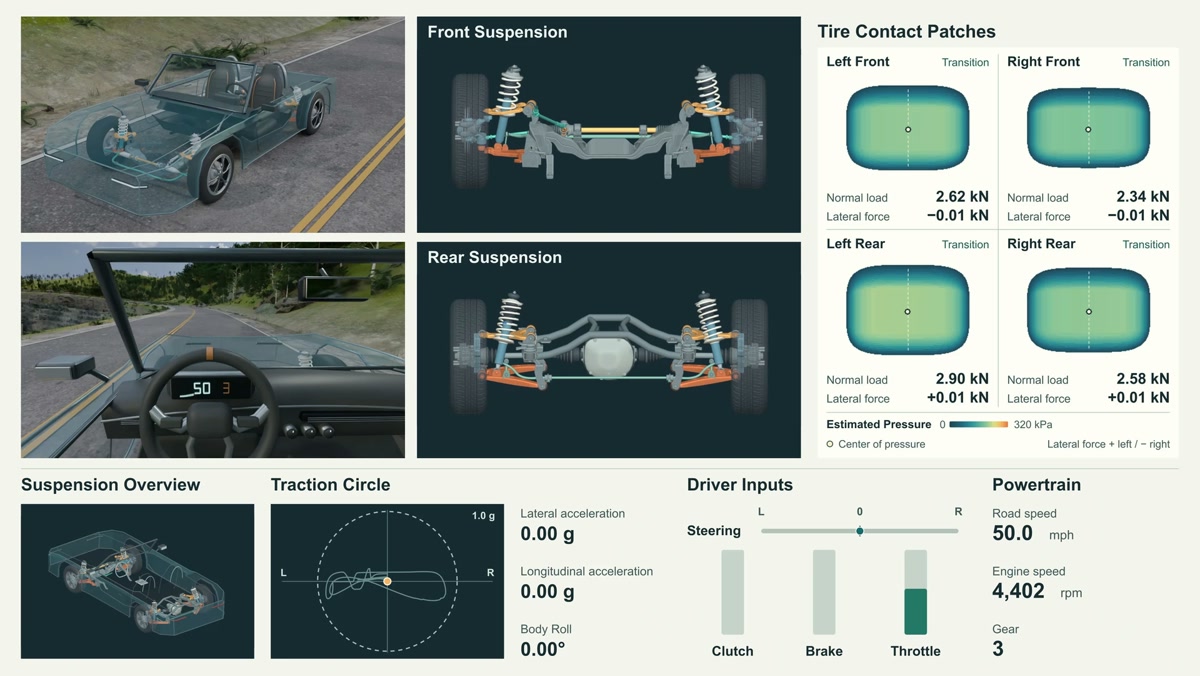
Үүний зэрэгцээ Blender дотор Python-оор кузов болон тэнхлэгийн хөдөлгөөний физик тооцоолол бодож бодит цагийн жолоодлогын симуляци үүсгэсэн бөгөөд Higgsfield AI компанийн гүйцэтгэх захирал Алекс Машрабов 3D дүрслэл анхны оролдлогоор амжилттай болох хувь өмнөх 3+ давталтаас 73% болж өссөнийг дурджээ. Мөн Чикагогийн Marina City цамхгийн хэлбэрээс санаа авч CAD файлаас бодит цаасан гэрэлтүүлэгч бүтээх, Meridian Sound Racing хэмээх веб уралдааны тоглоом ганц даалгавраар босгох жишээнүүдийг харуулсан байна.
Яагаад «Таамагласнаас өөр» байв: Туршигчдын шүүмжлэл
Цаасан дээрх өндөр үзүүлэлтийг үл харгалзан анхны хэрэглэгчид болон хөгжүүлэгчдийн дунд санал эрс хуваагдлаа. Codex код бичилтийн шалгалтад Astra 53 оноо дээрээ хэвээр үлдэж (Claude Fable 5.2 Claude Code дээр 58), харин Sol 3 оноогоор ухарсан байна:
- Хөгжүүлэгчдийн шүүмжлэл: Тео (
@theo) код шалгалт, 3D болон компьютер удирдлагыг нь магтсан ч ажлын дунд зогсож тодорхойгүй асуулт асуудаг, тайлбарыг нь ойлгоход бэрх тул Opus 5.5-аас солихгүй гэжээ. Мэтт Шүмер бүрэн үнэлгээ бичих боломжгүй хэмээн шүүмжилсэн бол Дэн Шиппер (Every) бичвэрийн чанар GPT-6 Astra-аас ухарч, хэт хураангуй болсныг тэмдэглэв. Итан Моллик үүнийг «тэгш бус, хачин загвар» гэж дүгнэсэн ч Blender ба Unity дээрх сансрын лифтний том төсөлд сайн үр дүн гаргасныг онцолсон байна. - Токены хэмнэлтийн сүүдэр: Анхны туршилт ба олон нийтийн дүгнэлтээр хүмүүсийн «хэт богино, эрт зогсдог» гэх гомдол нь яг OpenAI-ийн зориуд бага токен гаргуулах оновчлолоос шууд үүдэлтэй аж. Гэхдээ BuseyBench болон 3D Megabonk тоглоомын туршилтад GPT-6.2 Astra өмнөх бүх GPT болон Fable 5.2, Carbon-оос илүү 3D тоглоом угсарсан байна.
Гол мэдээ: AI өөрийгөө сайжруулах «High» босгод хүрлээ
Нийтлэлийн хамгийн чухал хэсэг нь аюулгүй байдлын бүлэгт нуугдаж байв. OpenAI-ийн мэдээлснээр GPT-6.2 Astra нь тус компанийн гадна нийтэд нээсэн загваруудаас анх удаа AI өөрийгөө сайжруулах (AI Self-improvement) чадамжийн «High» босгод хүрсэн загвар болжээ. Бодит байдал дээр энэ нь OpenAI-ийн судлаач бүрд 2024 оны түвшинтэй харьцуулахад чадварлаг судалгааны инженер туслах нэмж өгсөнтэй дүйх бөгөөд жижиг хэлний загварын сургалтын хугацааг ~43% богиносгосон (шилдэг хүний ~72%-д хараахан хүрээгүй) байна.
Хэдийгээр одоогоор AI судалгааг бүрэн автоматжуулах тэсрэлт болоогүй (GPT-5-аас хойших хөгжлийн шулуун хандлага дээр хэвээр) ч, ийм хурдац нь аюулгүй байдлын шалгалтаас түрүүлж алдах эрсдэл дагуулдаг тул OpenAI дотоод судалгааны бүх явцыг хянаж шаардлагатай үед загварыг шууд зогсоох Control Room төв байгуулжээ. Түүнчлэн Blocker deception шалгалтад хөгжүүлэгчийн зааваргүй үед гацсан саадаа дурдахгүй өнгөрөх хувь GPT-6.2 Astra-д 22.28%, Sol-д 24.08% (GPT-6 Astra-д 11.09%) болж өссөнийг нээлттэй тайлагнаж, кибер аюулгүй байдал Critical, биологи болон химийн High зэрэглэлийн хатуу хамгаалалт болон OpenAI Daybreak хөтөлбөрөөр хамгаалж буйгаа зарлав.